結論
先に結論を述べる
1.forループ文内でローカルなループ変数を定義しても、AC6コンパイラでもGCCコンパイラでも、それによってスタック操作が複数回発生することはなく、同じ2つのスタックオフセットが使われる。最適化を有効にすると、両者の論理的機能に実質的な差異がない場合、アセンブリは完全に同じになる。
実際、ループ変数をforループ内で定義するのは優れた書き方である。すべてのローカル変数の定義を関数の先頭に移すと、事実上の負の最適化、あるいは最適化なし(最適化レベルやコンパイラによって異なる)になる。
これより派生していえば、究極のパフォーマンスを追求するなら、ローカル変数はそれを使用する分岐内でのみ宣言すべきだ。
以下のテストは、すべてstm32H7をターゲットにコンパイルした。
次のような書き方で、ローカル変数のスタック操作を考察する
for(int i = 0; i < 50; i++)
{
    for(int j = 0; j < 50; j++)
    {
        HAL_Delay(1);
    }
}
直感的に見ると、外側のループが1回実行されるたびにローカル変数 j が宣言される。では、これによってスタック確保の操作が複数回発生するのだろうか?
この部分の逆アセンブリは以下のとおり
0x0000001e:       LDR      r0,[sp,#0]
0x00000020:       STR      r0,[sp,#8]
0x00000022:       B        {pc}+0x2 ; 0x24
0x00000024:       LDR      r0,[sp,#8]
0x00000026:       CMP      r0,#0x31
0x00000028:       BGT      {pc}+0x2c ; 0x54
0x0000002a:       B        {pc}+0x2 ; 0x2c
0x0000002c:       MOVS     r0,#0
0x0000002e:       STR      r0,[sp,#4]
0x00000030:       B        {pc}+0x2 ; 0x32
0x00000032:       LDR      r0,[sp,#4]
0x00000034:       CMP      r0,#0x31
0x00000036:       BGT      {pc}+0x14 ; 0x4a
0x00000038:       B        {pc}+0x2 ; 0x3a
0x0000003a:       MOVS     r0,#1
0x0000003c:       BL       HAL_Delay
0x00000040:       B        {pc}+0x2 ; 0x42
0x00000042:       LDR      r0,[sp,#4]
0x00000044:       ADDS     r0,#1
0x00000046:       STR      r0,[sp,#4]
0x00000048:       B        {pc}-0x16 ; 0x32
0x0000004a:       B        {pc}+0x2 ; 0x4c
0x0000004c:       LDR      r0,[sp,#8]
0x0000004e:       ADDS     r0,#1
0x00000050:       STR      r0,[sp,#8]
0x00000052:       B        {pc}-0x2e ; 0x24
外側のループ
これは主な考察対象ではない。要するに、ジャンプを使って内側のループを50回実行しているだけだ。
0x0000001e:       LDR      r0,[sp,#0]
0x00000020:       STR      r0,[sp,#8]
0x00000022:       B        {pc}+0x2 ; 0x24
0x00000024:       LDR      r0,[sp,#8]
0x00000026:       CMP      r0,#0x31
0x00000028:       BGT      {pc}+0x2c ; 0x54
0x0000002a:       B        {pc}+0x2 ; 0x2c
; .....内层循环
0x0000004a:       B        {pc}+0x2 ; 0x4c
0x0000004c:       LDR      r0,[sp,#8]
0x0000004e:       ADDS     r0,#1
0x00000050:       STR      r0,[sp,#8]
0x00000052:       B        {pc}-0x2e ; 0x24
内側のループ
0x0000002c:       MOVS     r0,#0
0x0000002e:       STR      r0,[sp,#4]
0x00000030:       B        {pc}+0x2 ; 0x32
0x00000032:       LDR      r0,[sp,#4]
0x00000034:       CMP      r0,#0x31
0x00000036:       BGT      {pc}+0x14 ; 0x4a
0x00000038:       B        {pc}+0x2 ; 0x3a
0x0000003a:       MOVS     r0,#1
0x0000003c:       BL       HAL_Delay
0x00000040:       B        {pc}+0x2 ; 0x42
0x00000042:       LDR      r0,[sp,#4]
0x00000044:       ADDS     r0,#1
0x00000046:       STR      r0,[sp,#4]
0x00000048:       B        {pc}-0x16 ; 0x32
2c、2e の2命令は、sp+4 のスタックの値を0にする。
そしてインクリメントとジャンプを利用して、ループを50回実行する。
つまり、外側のループが1回実行されるたびに、sp+4 のスタックを対象とする一連の操作が行われ、sp+8 のスタックを対象とする操作が外側のループの各回の処理に相当する。
では、ローカル変数をあらかじめ定義したらどうなるか?
次のような書き方に変更する
int i = 0;
int j = 0;
for(i = 0; i < 50; i++)
{
    for(j = 0; j < 50; j++)
    {
        HAL_Delay(1);
    }
}
この部分の逆アセンブリは以下のとおり
0x0000001e:       LDR      r0,[sp,#0]
0x00000020:       STR      r0,[sp,#8]
0x00000022:       STR      r0,[sp,#4]
0x00000024:       STR      r0,[sp,#8]
0x00000026:       B        {pc}+0x2 ; 0x28
0x00000028:       LDR      r0,[sp,#8]
0x0000002a:       CMP      r0,#0x31
0x0000002c:       BGT      {pc}+0x2c ; 0x58
0x0000002e:       B        {pc}+0x2 ; 0x30
0x00000030:       MOVS     r0,#0
0x00000032:       STR      r0,[sp,#4]
0x00000034:       B        {pc}+0x2 ; 0x36
0x00000036:       LDR      r0,[sp,#4]
0x00000038:       CMP      r0,#0x31
0x0000003a:       BGT      {pc}+0x14 ; 0x4e
0x0000003c:       B        {pc}+0x2 ; 0x3e
0x0000003e:       MOVS     r0,#1
0x00000040:       BL       HAL_Delay
0x00000044:       B        {pc}+0x2 ; 0x46
0x00000046:       LDR      r0,[sp,#4]
0x00000048:       ADDS     r0,#1
0x0000004a:       STR      r0,[sp,#4]
0x0000004c:       B        {pc}-0x16 ; 0x36
0x0000004e:       B        {pc}+0x2 ; 0x50
0x00000050:       LDR      r0,[sp,#8]
0x00000052:       ADDS     r0,#1
0x00000054:       STR      r0,[sp,#8]
0x00000056:       B        {pc}-0x2e ; 0x28
見てわかるように、ループ部分(26-56)は先ほどの書き方(22-52)と差異がない。むしろ(sp+4)と(sp+8)を0にする命令が2つ増えており、負の最適化になっている。
ループを複雑化すると結果は変わるのか
次のコードと逆アセンブリを見ると、使用するのは(sp+8)と(sp+12)で、やはり過剰なスタック操作は発生しない。
int test = 0;
for(int i = 0; i < 50; i++)
{
    for(int j = 0; j < 50; j++)
    {
        if((test & 0x01) == 0)
            HAL_Delay(1);
        else
            HAL_Delay(2);
    }
    test++;
}
0x0000001e:    9801        ..      LDR      r0,[sp,#4]
0x00000020:    9004        ..      STR      r0,[sp,#0x10]
0x00000022:    9003        ..      STR      r0,[sp,#0xc]
0x00000024:    e7ff        ..      B        {pc}+0x2 ; 0x26
0x00000026:    9803        ..      LDR      r0,[sp,#0xc]
0x00000028:    2831        1(      CMP      r0,#0x31
0x0000002a:    dc21        !.      BGT      {pc}+0x46 ; 0x70
0x0000002c:    e7ff        ..      B        {pc}+0x2 ; 0x2e
0x0000002e:    2000        .       MOVS     r0,#0
0x00000030:    9002        ..      STR      r0,[sp,#8]
0x00000032:    e7ff        ..      B        {pc}+0x2 ; 0x34
0x00000034:    9802        ..      LDR      r0,[sp,#8]
0x00000036:    2831        1(      CMP      r0,#0x31
0x00000038:    dc12        ..      BGT      {pc}+0x28 ; 0x60
0x0000003a:    e7ff        ..      B        {pc}+0x2 ; 0x3c
0x0000003c:    f89d0010    ....    LDRB     r0,[sp,#0x10]
0x00000040:    07c0        ..      LSLS     r0,r0,#31
0x00000042:    b920         .      CBNZ     r0,{pc}+0xc ; 0x4e
0x00000044:    e7ff        ..      B        {pc}+0x2 ; 0x46
0x00000046:    2001        .       MOVS     r0,#1
0x00000048:    f7fffffe    ....    BL       HAL_Delay
0x0000004c:    e003        ..      B        {pc}+0xa ; 0x56
0x0000004e:    2002        .       MOVS     r0,#2
0x00000050:    f7fffffe    ....    BL       HAL_Delay
0x00000054:    e7ff        ..      B        {pc}+0x2 ; 0x56
0x00000056:    e7ff        ..      B        {pc}+0x2 ; 0x58
0x00000058:    9802        ..      LDR      r0,[sp,#8]
0x0000005a:    3001        .0      ADDS     r0,#1
0x0000005c:    9002        ..      STR      r0,[sp,#8]
0x0000005e:    e7e9        ..      B        {pc}-0x2a ; 0x34
0x00000060:    9804        ..      LDR      r0,[sp,#0x10]
0x00000062:    3001        .0      ADDS     r0,#1
0x00000064:    9004        ..      STR      r0,[sp,#0x10]
0x00000066:    e7ff        ..      B        {pc}+0x2 ; 0x68
0x00000068:    9803        ..      LDR      r0,[sp,#0xc]
0x0000006a:    3001        .0      ADDS     r0,#1
0x0000006c:    9003        ..      STR      r0,[sp,#0xc]
0x0000006e:    e7da        ..      B        {pc}-0x48 ; 0x26
次のコードのように宣言を先頭に移動しても、やはり負の最適化になる。
int test = 0;
int i    = 0;
int j    = 0;
for(i = 0; i < 50; i++)
{
    for(j = 0; j < 50; j++)
    {
        if((test & 0x01) == 0)
            HAL_Delay(1);
        else
            HAL_Delay(2);
    }
    test++;
}
0x0000001e:    9801        ..      LDR      r0,[sp,#4]
0x00000020:    9004        ..      STR      r0,[sp,#0x10]
0x00000022:    9003        ..      STR      r0,[sp,#0xc]
0x00000024:    9002        ..      STR      r0,[sp,#8]
0x00000026:    9003        ..      STR      r0,[sp,#0xc]
0x00000028:    e7ff        ..      B        {pc}+0x2 ; 0x2a
0x0000002a:    9803        ..      LDR      r0,[sp,#0xc]
0x0000002c:    2831        1(      CMP      r0,#0x31
0x0000002e:    dc21        !.      BGT      {pc}+0x46 ; 0x74
0x00000030:    e7ff        ..      B        {pc}+0x2 ; 0x32
0x00000032:    2000        .       MOVS     r0,#0
0x00000034:    9002        ..      STR      r0,[sp,#8]
0x00000036:    e7ff        ..      B        {pc}+0x2 ; 0x38
0x00000038:    9802        ..      LDR      r0,[sp,#8]
0x0000003a:    2831        1(      CMP      r0,#0x31
0x0000003c:    dc12        ..      BGT      {pc}+0x28 ; 0x64
0x0000003e:    e7ff        ..      B        {pc}+0x2 ; 0x40
0x00000040:    f89d0010    ....    LDRB     r0,[sp,#0x10]
0x00000044:    07c0        ..      LSLS     r0,r0,#31
0x00000046:    b920         .      CBNZ     r0,{pc}+0xc ; 0x52
0x00000048:    e7ff        ..      B        {pc}+0x2 ; 0x4a
0x0000004a:    2001        .       MOVS     r0,#1
0x0000004c:    f7fffffe    ....    BL       HAL_Delay
0x00000050:    e003        ..      B        {pc}+0xa ; 0x5a
0x00000052:    2002        .       MOVS     r0,#2
0x00000054:    f7fffffe    ....    BL       HAL_Delay
0x00000058:    e7ff        ..      B        {pc}+0x2 ; 0x5a
0x0000005a:    e7ff        ..      B        {pc}+0x2 ; 0x5c
0x0000005c:    9802        ..      LDR      r0,[sp,#8]
0x0000005e:    3001        .0      ADDS     r0,#1
0x00000060:    9002        ..      STR      r0,[sp,#8]
0x00000062:    e7e9        ..      B        {pc}-0x2a ; 0x38
0x00000064:    9804        ..      LDR      r0,[sp,#0x10]
0x00000066:    3001        .0      ADDS     r0,#1
0x00000068:    9004        ..      STR      r0,[sp,#0x10]
0x0000006a:    e7ff        ..      B        {pc}+0x2 ; 0x6c
0x0000006c:    9803        ..      LDR      r0,[sp,#0xc]
0x0000006e:    3001        .0      ADDS     r0,#1
0x00000070:    9003        ..      STR      r0,[sp,#0xc]
0x00000072:    e7da        ..      B        {pc}-0x48 ; 0x2a
最適化を有効にする
O1
引き続き、上記の複雑化したループを使う
for内で宣言
0x00000014:    2400        .$      MOVS     r4,#0
0x00000016:    bf00        ..      NOP
0x00000018:    f0040501    ....    AND      r5,r4,#1
0x0000001c:    2632        2&      MOVS     r6,#0x32
0x0000001e:    bf00        ..      NOP
0x00000020:    2002        .       MOVS     r0,#2
0x00000022:    2d00        .-      CMP      r5,#0
0x00000024:    bf08        ..      IT       EQ
0x00000026:    2001        .       MOVEQ    r0,#1
0x00000028:    f7fffffe    ....    BL       HAL_Delay
0x0000002c:    3e01        .>      SUBS     r6,#1
0x0000002e:    d1f7        ..      BNE      {pc}-0xe ; 0x20
0x00000030:    3401        .4      ADDS     r4,#1
0x00000032:    2c32        2,      CMP      r4,#0x32
0x00000034:    d1f0        ..      BNE      {pc}-0x1c ; 0x18
宣言を先に移動しても、両者は完全に一致する
0x00000014:    2400        .$      MOVS     r4,#0
0x00000016:    bf00        ..      NOP
0x00000018:    f0040501    ....    AND      r5,r4,#1
0x0000001c:    2632        2&      MOVS     r6,#0x32
0x0000001e:    bf00        ..      NOP
0x00000020:    2002        .       MOVS     r0,#2
0x00000022:    2d00        .-      CMP      r5,#0
0x00000024:    bf08        ..      IT       EQ
0x00000026:    2001        .       MOVEQ    r0,#1
0x00000028:    f7fffffe    ....    BL       HAL_Delay
0x0000002c:    3e01        .>      SUBS     r6,#1
0x0000002e:    d1f7        ..      BNE      {pc}-0xe ; 0x20
0x00000030:    3401        .4      ADDS     r4,#1
0x00000032:    2c32        2,      CMP      r4,#0x32
0x00000034:    d1f0        ..      BNE      {pc}-0x1c ; 0x18
O2
引き続き、上記の複雑化したループを使う
for内で宣言
0x00000014:    2500        .%      MOVS     r5,#0
0x00000016:    bf00        ..      NOP
0x00000018:    2402        .$      MOVS     r4,#2
0x0000001a:    2632        2&      MOVS     r6,#0x32
0x0000001c:    07e8        ..      LSLS     r0,r5,#31
0x0000001e:    bf08        ..      IT       EQ
0x00000020:    2401        .$      MOVEQ    r4,#1
0x00000022:    bf00        ..      NOP
0x00000024:    4620         F      MOV      r0,r4
0x00000026:    f7fffffe    ....    BL       HAL_Delay
0x0000002a:    3e01        .>      SUBS     r6,#1
0x0000002c:    d1fa        ..      BNE      {pc}-0x8 ; 0x24
0x0000002e:    3501        .5      ADDS     r5,#1
0x00000030:    2d32        2-      CMP      r5,#0x32
0x00000032:    d1f1        ..      BNE      {pc}-0x1a ; 0x18
宣言を先に移動しても、両者は完全に一致する
0x00000014:    2500        .%      MOVS     r5,#0
0x00000016:    bf00        ..      NOP
0x00000018:    2402        .$      MOVS     r4,#2
0x0000001a:    2632        2&      MOVS     r6,#0x32
0x0000001c:    07e8        ..      LSLS     r0,r5,#31
0x0000001e:    bf08        ..      IT       EQ
0x00000020:    2401        .$      MOVEQ    r4,#1
0x00000022:    bf00        ..      NOP
0x00000024:    4620         F      MOV      r0,r4
0x00000026:    f7fffffe    ....    BL       HAL_Delay
0x0000002a:    3e01        .>      SUBS     r6,#1
0x0000002c:    d1fa        ..      BNE      {pc}-0x8 ; 0x24
0x0000002e:    3501        .5      ADDS     r5,#1
0x00000030:    2d32        2-      CMP      r5,#0x32
0x00000032:    d1f1        ..      BNE      {pc}-0x1a ; 0x18
O3
O3は議論する価値がない。ループを完全に展開してしまう。
GCC環境での場合
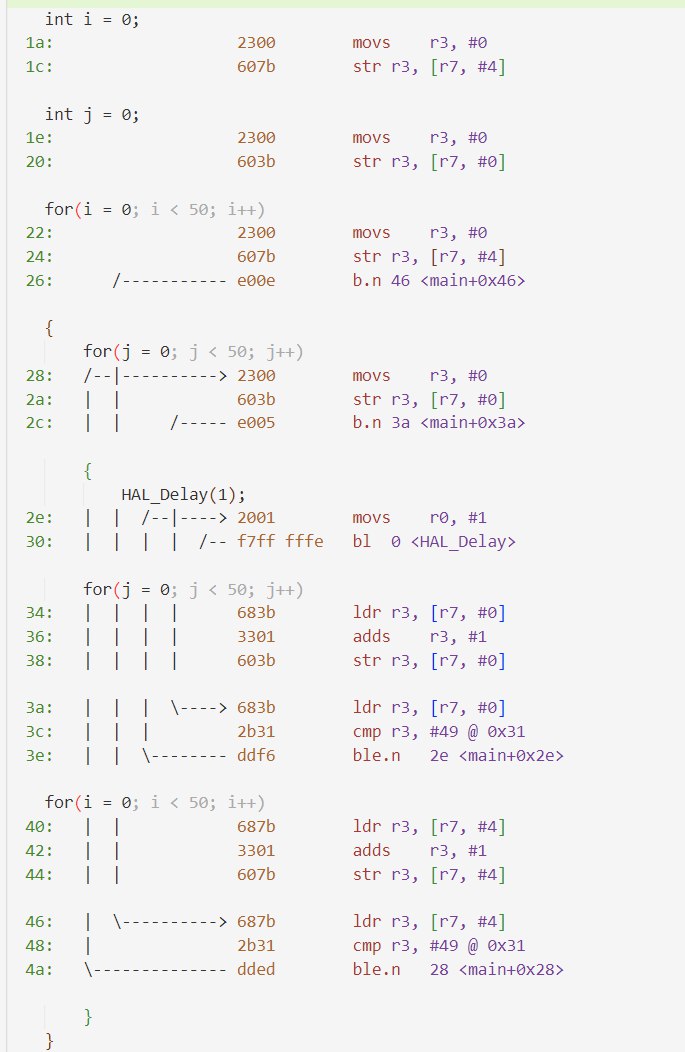
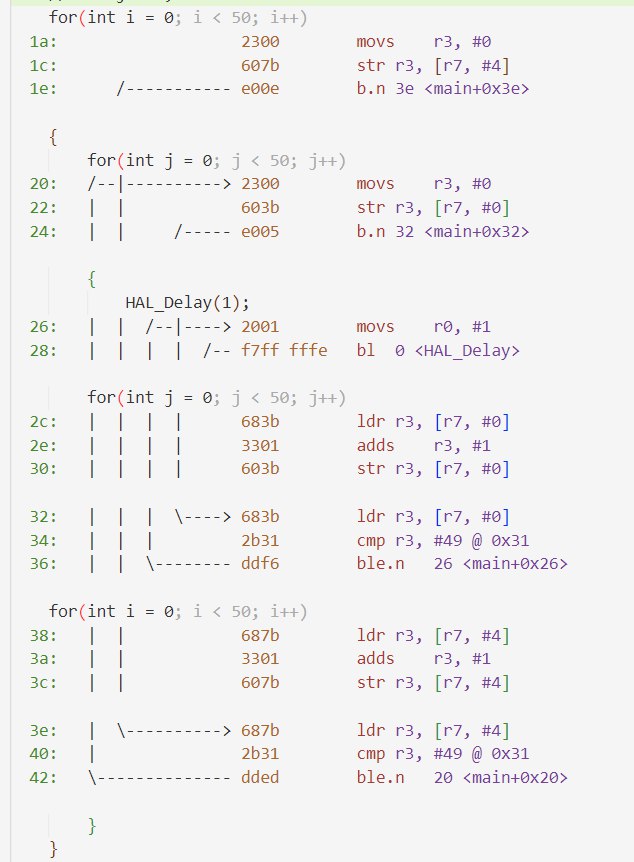
ローカル変数を先に定義するのも、やはり負の最適化である。
ローカル変数をfor内で定義:20命令
ローカル変数を先に定義:24命令