はじめに
私はソフトウェアの専門出身ではない。これまでプログラミング設計を能動的にも受動的にもきちんと学んだことはなく、あくまで観察と実践に基づく経験主義でやってきた。
一方、ボード上の組込み開発は実のところ、そういったことを重視しない。重視されるのはRAM/ROM使用量、実行速度、業務ロジックが要件を満たすかどうかだ。その結果、深刻な問題が生じる。そうした職場での成果物は、ほとんどが特定の製品専用にカスタマイズされたものになってしまうのだ。
ここで議論したいことが2つある。
- 本当にリソースが制約されたMCUでは、再利用可能なコードは使えないのだろうか? 私は否だと思う。理由は後述する。
- こうしたカスタマイズされたソフトウェアのコードをアーカイブしても、コメントは極端に少なく、説明もほぼない。それを本当に
ソフトウェア資産と呼べるだろうか? 私個人としては否だと思う。私の認識では、初心者が8時間以内に誰の指導もなしに使えるようにならないソフトウェアモジュールは、すべて不合格だ。
最近、真のソフトウェア資産をどうやって生み出すかを考えたいと思い、基礎的なプログラミング設計を学ぶ必要が出てきた。なので10分かけて完全に理解した
以下は、こうした設計についての机上の空論だ。笑い飛ばしてくれて構わない。私自身、これらを実際にまともに実践したことはほとんどない。
オブジェクト指向プログラミング
オブジェクト指向は言い尽くされた言葉だ。実のところ、私はあの専門用語をまったく理解できていない。
私の見方では、オブジェクト指向の神髄は、ひとつの物の定義をすることにある。つまり、ある物がどのような機能・変数・定量を持つかを定義するのだ。例えばキーボードを定義しよう。定量として104キー、機能として「Aを押す」「Bを押す」を持つ。
でも、おかしい。市場には奇妙な形のキーボードがいろいろあるじゃないか。これがいわゆる「継承」というやつだ。奇妙な形のキーボードは、標準のキーボードクラスの一部を書き換えているにすぎない。例えば、テンキーの「1を押す」機能を無効化したり、定量を88キーだと書き換えたりする。
オブジェクト指向の世界では、すべてがオブジェクトとして定義される。そして私たちはオブジェクトを定義し、そのイメージを固定し、継承で拡張していく。そうすればモジュールを具現化できる。さらに複数のオブジェクトを組み合わせれば、プロジェクトを具現化できる。
私は、移植の難しさと機能を天秤にかけたとき、オブジェクト指向プログラミングこそモジュール化・カプセル化の最良の実装だと思う(今のところはそう考えている)。
だが、プロジェクトの観点から見ると、オブジェクト指向は非常に不親切かもしれない。プロジェクトの進行中に、あるオブジェクトの定義が変わってしまったらどうだろう。システム全体が大きく変わってしまい、コードの臭いの発生源を突き止めるのが難しくなる。かといって、各オブジェクトを使うたびに中間層を追加で書いて隔離しようとすれば、まったくの蛇足で、新しい定義を増やすだけだ。要するに、定義の変更による影響が大きすぎる。これは実際、保守する側にとってあまり優しいとは言えない。
もちろん、通信プロトコルやインターフェースプロトコルといった標準化されたものは、大胆にオブジェクト化してよい。だが、プロジェクトの値打ちは、往々にして非標準の部分にある。
私たちが実際に望んでいるのは、気持ちよくやれることだ。あれこれ気を遣い、レベルがバラバラで、どこもかしこも混沌としている——そんなのは気持ちよくない。
関数型プログラミング
主な参考:1.7. 圏論入門 (*) - バナナスペース。この参考資料は数学の知識のみを紹介しており、プログラミングには触れていない。
実はこれはそれほど難しい話ではない。すべてが関数だ。しかし、すべてが関数でありながら業務機能を実現できるというのが、なかなか不思議だ。
関数型プログラミングには、次の2つの最も重要なルールがある(私がそう言っているだけだ)。
- あらゆる関数は、入力と戻り値を持つ必要がある。
- あらゆる関数は、いかなる状況でも、同じ入力には同じ戻り値を返す。
私の見方では、関数型の神髄は、副作用がなく機能が決定的な関数を手に入れることにある。入力を決定的に出力へ変換するための関数だ。
下の図では、それぞれの矢印が1つの関数であり、それぞれの点は入力でもあり出力でもある。例えば、左から1つ目の矢印を見てみよう。最初の点がこの関数に入力され、出力が2番目の点になる。そして2番目の点は、2つの関数を通せばさらに別の2つの点になる。ここでの点は何でもよい。もちろん、この考え方ではあらゆるものが関数だ。実数値は出力が固定された関数であり、変数を取ることは恒等射[^恒等射]である。
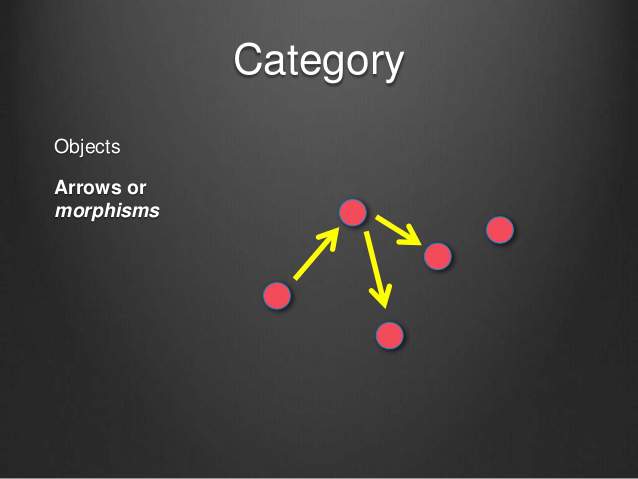
画像は[関数型プログラミング入門チュートリアル - 阮一峰のブログhttps://ruanyifeng.com/blog/2017/02/fp-tutorial.html
例えば、CRC16アルゴリズムの実装や、さまざまな古典暗号アルゴリズムの実装は、間違いなく関数型プログラミングだ。検証対象の値の組/平文は、関数を通せば必ず、チェックサムの組/暗号文を出力する。その検証処理や解析処理も同様に関数型的であり、したがってこの2つのシナリオでは入力と出力は同型[^同型]である。
こうしてみると、純粋な数学の問題は、関数型プログラミングを使えばどれも簡単だ。「数学は世界を記述できるんだぞ」と突っかかってくるのはやめてほしい。oi oi。
しかし実際のエンジニアリングでは、すべての状態を単純に定義することはできない。入出力が大きくなれば、関数を書くのも困難が多く、関数の数の規模も、おそらく小さくは済まない。問題を分解していけば、関数の数は膨大だ。もちろん何より厄介なのは、この上なく憎たらしいプロダクトマネージャーが際限なく要件を変えることだ。新しいバカな顧客が来れば、新しいバカ防止機構も生まれる。そうした状況は、関数型プログラミングの開発環境をさらに悪化させる。
実のところ関数型プログラミングは、工業的な考え方に合っている。決まった動作には決まったフィードバックが返ってくる。限られた状況だけを対象にした業務ロジックなら、管理が比較的面倒なステートマシンではなく、関数型プログラミングを大いに使ってよい。
ここで前言の「議論1:本当にリソースが制約されたMCUでは再利用可能なコードは使えないのか?」に戻ろう。関数型プログラミングは、どのような状況でも消費するリソースが似通っている。圏[^圏]を縮小して、不要な関数を直接削除すれば、再利用が実現できる。
私の見解では、数学関連の関数の一部を関数型で書くのは良いカプセル化だ。だが、この考え方をエンジニアリングや業務に持ち込む必要はまったくない。作業量が純粋に指数関数的に増えるだけだ。
標準コマンドの生成も、関数型に向いた良い方向性かもしれない。機会があれば改造してみたい。
手続き型プログラミング
ここまで述べた2つのプログラミング手法は、どちらも関数・メソッドの副作用を減らすことで、異なるシステムでもほぼ同じ機能が得られるようにするものだ。手続き型はそれとは違う。手続き型の神髄は、副作用を使って目的の機能を得ることであり、引数や戻り値を各種関数・メソッドの間で引き回して機能を得ることではない。
手続き型は、人間が解決策を考えるときの考え方に最も合ったプログラミング方式だ。詳しくは述べない。誰でも分かっているだろう。
まとめ
要するに、ソフトウェア資産の階層構造として、最下層は関数型プログラミングによるコンポーネントモジュールとし、機能モジュールはオブジェクト指向プログラミングで実装して関数型コンポーネントを呼び出す——これが私が考えた結果だ。
最も古典的な例、「象を冷蔵庫に入れる」を考えてみよう。
オブジェクト指向プログラミングでは、象オブジェクトの定義と、冷蔵庫の定義(保管スペース、入れるメソッド、取り出すメソッドを含む)が必要だ。2つのオブジェクトをインスタンス化し、その後、冷蔵庫の入れるメソッドを使う。
関数型プログラミングでは、あらかじめ3つの対象を定義する——空の対象、冷蔵庫と象、象が入った冷蔵庫だ。関数1は「空の対象」を渡すと「冷蔵庫と象」を出力し、関数2は「冷蔵庫と象」を渡すと「象が入った冷蔵庫」を出力する。
手続き型プログラミングでは、象を捕まえる関数(副作用:象が生まれる)、冷蔵庫を買う関数(副作用:冷蔵庫が生まれる)、象を冷蔵庫に詰め込む関数(副作用:冷蔵庫が象の詰まった冷蔵庫に変わる)。
余談
どこかで見た言葉を覚えている。「ほとんどの上司は、部下を指揮するとき手続き型的だ。そんな状況では、関数型プログラミングによる開発をまともに進めることはできない」——だいたいそんな意味だったと思う。
私は以前から、ソフトウェアシステムの構築は、マネジメント/会社/製品といったシステムの構築と似ているところがあると思っている。良い設計、良いアーキテクチャは、その後の拡張・保守・管理コストを大幅に下げてくれる。ただ、その代わりにアーキテクトの脳細胞が大量に焼かれる。そして、ほとんどのアーキテクトは、人間の思考に最も近い手続き型でしか考えようとしない。